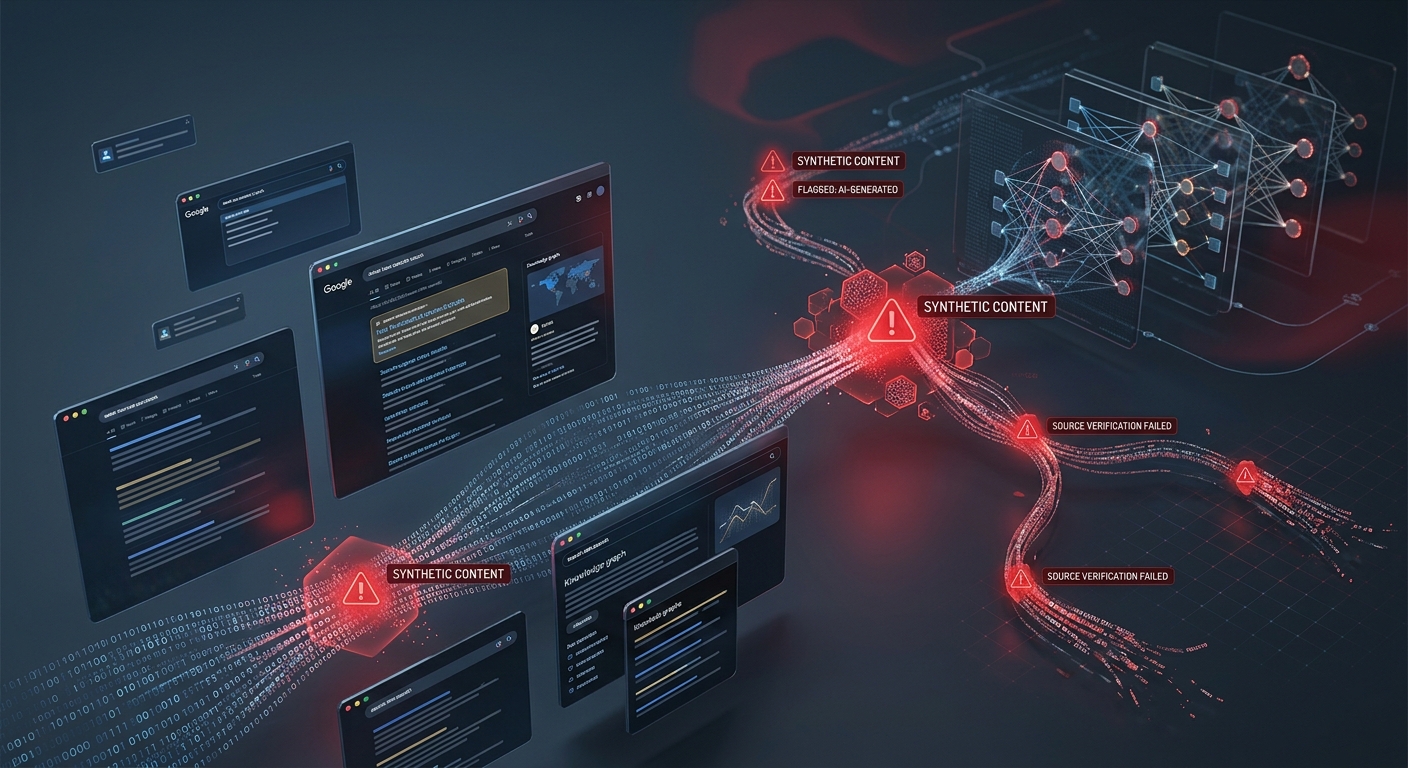
2026 թվականի ապրիլին՝ Հայաստանի խորհրդարանական ընտրություններից ընդամենը երկու ամիս առաջ, ռուսական Social Design Agency (SDA) կազմակերպությունը մշակել էր Վիքիպեդիայի նմանությամբ մի «կլոն»՝ նախատեսված նոր էջերի ավտոմատ ստեղծման համար։ Սակայն դրա նպատակը միայն ընթերցողներին հասնելը չէր: Ըստ Bloomberg-ի հետաքննության՝ համակարգը նախատեսված էր նաև Google-ի որոնման ալգորիթմների և արհեստական բանականության մոդելների վրա ազդելու համար, որոնք տեղեկատվություն են հավաքում համացանցում հասանելի բովանդակությունից։
Այս մասին հայտնի դարձավ Bloomberg-ի՝ 2026 թվականի հունիսի 24-ին հրապարակված հետաքննությունից, որը հիմնված էր SDA-ից արտահոսած 73 փաստաթղթի վրա։ Դրանց մի մասն ավելի վաղ բացահայտել էր հայկական Fact Investigation Platform-ը: Փաստաթղթերը ցույց են տալիս, որ Հայաստանի վերաբերյալ նախագիծը SDA-ի ավելի լայն տեղեկատվական գործունեության մի մասն էր։
Այս դեպքը ցույց է տալիս, որ այսօր ապատեղեկատվությունը տարածելու համար պարտադիր չէ մարդկանց ուղղակիորեն կեղծ տեղեկություն մատուցել։ Կարելի է փորձել ազդել նաև այն աղբյուրների վրա, որոնցից մարդիկ կամ արհեստական բանականության համակարգերը տեղեկություն են ստանում։ Այս դեպքում թիրախավորվում է ոչ միայն ընթերցողը, այլև այն տեղեկատվությունը, որը հետագայում կարող է հասանելի դառնալ նրան։
Ինչ էին ծրագրել
SDA-ի՝ ապրիլի 14-ով թվագրված փաստաթուղթը Հայաստանի համար նկարագրում էր մի նախագիծ, որը կազմակերպությունն անվանում էր «ինքնալցվող գիտելիքի բազա»։ Այն պետք է կառուցված լիներ Վիքիպեդիայի նմանությամբ և մշտապես համալրվեր նոր էջերով։
Ծրագրի տրամաբանությունը պարզ էր՝ ստեղծել տեղեկատվություն, որը կթվա սովորական տեղեկատու բովանդակություն, բայց միաժամանակ կկարողանա հայտնվել որոնման արդյունքներում և հասանելի դառնալ այն համակարգերին, որոնք համացանցից տեղեկատվություն են հավաքում։
Ըստ Bloomberg-ի՝ ծրագրի փաստաթղթում նույնիսկ նկարագրված էր կոնկրետ մեթոդ։ Կայքի համար նախատեսվում էր հետևել, թե որ հոդվածներն են առավել հաճախ որոնվում կամ ընթերցվում, և այդ էջերում տեղադրել համապատասխան բովանդակություն, հղումներ ու տեղեկատվական բլոկներ։ Այսինքն՝ պետք էր ոչ թե պարզապես ստեղծել մեծ քանակությամբ նյութ, այլ դրանք հասցնել այն էջերին, որոնց հանդիպելու հավանականությունը սովորական օգտատիրոջ համար ավելի մեծ էր։
Ծրագրի հեղինակները նաև բավական կոնկրետ արդյունքներ էին կանխատեսում։ Փաստաթղթերում նշվում էր, որ առաջին երեք ամիսներին կայքը պետք է օրական մոտ 5000 այցելու ունենար, իսկ լսարանը հետագայում պետք է ամսական 30 տոկոսով աճեր։ Թվերը ինքնին դեռ չեն նշանակում, որ այդ ցուցանիշները հնարավոր կլիներ իրականում ապահովել, բայց դրանք ցույց են տալիս, թե ինչ մասշտաբի հասնելու էր հաշվարկված նախագիծը։
Հայաստանի համար նախատեսված նախագիծը նաև SDA-ի առաջին նման փորձը չէր։ Նմանատիպ «գիտելիքի բազա» արդեն գործում էր Գերմանիայի վերաբերյալ, և 2026 թվականի սկզբին, ըստ SDA-ի ներքին փաստաթղթերի, այն արդեն ներառում էր ավելի քան 200 հազար էջ։ Բազան նախատեսվում էր շարունակաբար թարմացնել, այդ թվում՝ որոնողական համակարգերում դրա տեսանելիությունը պահպանելու համար։ Նախագծի մյուս նպատակը այդ բովանդակությունը արհեստական բանականության համակարգերի համար հասանելի դարձնելն էր: Փաստաթղթերում, մասնավորապես, նշվում էր ամսական 500 հոդվածի խմբագրման և վեց տարբեր AI հարթակներում այդ նյութերի ուսուցման մասին։
Հենց այս զուգահեռությունն է ցույց տալիս, որ Հայաստանի նախագիծը առանձին նախաձեռնություն չէր, այլ Գերմանիայում արդեն կիրառված մոտեցման տարածումն էր մեկ այլ երկրի վրա։ Տարբերությունը միայն թիրախային երկրի և տեղական բովանդակության մեջ էր, մինչդեռ մեթոդը նույնն էր՝ ստեղծել վստահելի թվացող տեղեկատվական աղբյուրներ և դրանց միջոցով հասանելիություն ստանալ որոնողական համակարգերում ու AI հարթակներում։
Ինչ գտավ Bloomberg-ը իրականում
Bloomberg-ի լրագրողները չբավարարվեցին փաստաթղթերի ուսումնասիրությամբ և փորձեցին ստուգել՝ արդյոք դրանցում նկարագրված նախագծերից որևէ մեկը իրականում կառուցվել էր։ Դոմենների գրանցման պատմական տվյալների միջոցով նրանք հայտնաբերեցին երեք կայք՝ spyurk.cyou, sevan.info և khachkar.info, որոնք բոլորն էլ գրանցվել էին 2026 թվականի հունվարին և տեղակայված էին նույն ռուսական IP հասցեի վրա։ Կայքերում կար Հայաստանին վերաբերող բովանդակություն, որի զգալի մասը պարզապես պատճենված էր ռուսերեն Վիքիպեդիայից։
Սակայն կայքերը նախատեսված չէին սովորական այցելուների համար։ Դրանք կառուցված էին այնպես, որ այցելուներին ավտոմատ ուղղորդեին այլ էջեր։ Bloomberg-ի ուսումնասիրության համաձայն՝ կայքերի հիմնական գործառույթը որոնողական համակարգերի ավտոմատ ծրագրերի համար հասանելի բովանդակություն ստեղծելն էր՝ այն համակարգերի, որոնք համացանցից տվյալներ են հավաքում որոնման արդյունքների և AI մոդելների աշխատանքի համար։
Ծրագրի փաստաթղթերում նշվում էր, որ կայքը պետք է տեղակայվեր Թուրքիայում՝ դրա ռուսական ծագումը թաքցնելու համար։ Իրականում spyurk.cyou-ի հոսթինգը կապված էր Դելավերում գրանցված մի ընկերության հետ, որն ունի գրասենյակ Թուրքիայում։ Երեք կայքերի հոսթինգն էլ հունիսի 9-ին դադարեցվել է հոսթինգ մատակարարի կողմից՝ առանց հրապարակային բացատրության։
Սակայն Bloomberg-ի հայտնաբերածը չի սահմանափակվում այս երեք կայքով։ Հետաքննության ընթացքում հայտնաբերվել էր նաև ավելի լայն ցանց, այդ թվում՝ erevan.one-ը և մի շարք այլ կայքեր, որոնք կառավարվում էին SDA-ի հետ համագործակցող SNG-Media խմբի կողմից։ Ի տարբերություն վերը նշված երեք կայքերի՝ այդ ռեսուրսները տեղակայված էին Ռուսաստանում և կապված էին ռուսական հեռահաղորդակցության կարգավորող մարմնի՝ Ռոսկոմնադզորի հետ։ Դրանք հունիսի 9-ին չեն փակվել։ Այսպիսով, հայտնաբերված երեք կայքերը, ըստ Bloomberg-ի տվյալների, ավելի լայն ենթակառուցվածքի միայն մի մասն էին։
Միևնույն ժամանակ, այստեղ կարևոր է տարբերակել փաստաթղթերում նկարագրված նպատակը և դրա իրական արդյունքը։ Bloomberg-ը չի հաստատել, որ այս բովանդակությունն իրականում հայտնվել է որևէ խոշոր AI ընկերության ուսուցման տվյալներում կամ էականորեն ազդել որոնման համակարգերի արդյունքների վրա։ Հաստատված է, թե ինչ էր նախատեսվում և ինչ կայքեր էին կառուցվել, բայց ոչ այն, թե դրանց բովանդակությունն ի վերջո ինչ ազդեցություն է ունեցել համապատասխան համակարգերի վրա։
Ինչով է այս մոտեցումը տարբերվում
Այստեղ կարևոր է հասկանալ, թե ինչով է այս մոտեցումը տարբերվում ապատեղեկատվության տարածման ավելի վաղ մեթոդներից։ Դասական թրոլային գործունեության դեպքում ազդեցությունը տեղի էր ունենում անմիջապես՝ կեղծ պրոֆիլի, գրառման կամ մեկնաբանության միջոցով։ Թիրախը կոնկրետ մարդն էր, և այդ բովանդակությանը կարելի էր նույն հարթակում հակադարձել կամ այն հերքել։
Այս մոտեցման դեպքում փոխվում է ազդեցության թիրախը․ խոսքը միայն ընթերցողի վրա անմիջականորեն ազդելու մասին չէ։ Փորձ է արվում ազդել նաև որոնողական համակարգերի և լեզվական մոդելների վրա, որոնք տեղեկատվությունը գտնում ու ներկայացնում են օգտատիրոջը։ Ատլանտյան խորհրդի հետազոտող Եկատերինա Սեդովան այս մարտավարությունը բնութագրում է որպես որոնողական համակարգերը միմյանց հղող, արհեստականորեն մեծածավալ բովանդակությամբ ողողելու փորձ, որպեսզի ալգորիթմը դրա բազմակի կրկնությունը ընկալի որպես վստահելիության ազդանշան։
Խնդիրն այն է, որ եթե սոցիալական ցանցում կեղծ գրառումը կարելի է գտնել, նշել ու հերքել, ապա լեզվական մոդելի ուսուցման տվյալների մեջ հայտնված նյութի աղբյուրը կարող է գործնականում անհասանելի մնալ օգտատիրոջը։ Չաթբոտից պատասխան ստացող մարդը հաճախ ընդհանրապես չգիտի, թե կոնկրետ պնդումը ինչ աղբյուրից է վերցվել։
Սեդովան նաև մատնանշում է այն խոցելիությունը, որ կարող է առաջանալ հայերենի նման լեզուների դեպքում, որոնցով առցանց բովանդակության ծավալը համեմատաբար սահմանափակ է։ Անգլերենով աշխատող արհեստական բանականության համակարգերի դեպքում նման մանիպուլյացիաները հայտնաբերելու համար ավելի մեծ ռեսուրսներ և մասնագիտական կարողություններ կան, մինչդեռ փոքր լեզուների դեպքում համապատասխան մասնագետների և տվյալների պակասը կարող է դժվարացնել նման բովանդակության հայտնաբերումը։ Հայերենի դեպքում սա հատկապես կարևոր է, քանի որ հայալեզու առցանց բովանդակության ծավալը զգալիորեն փոքր է անգլերենի համեմատ։ Հետևաբար, արհեստականորեն ստեղծված բովանդակության նույնիսկ համեմատաբար փոքր ծավալը կարող է ավելի նկատելի տեղ զբաղեցնել հասանելի տեղեկատվության մեջ։
Եզրակացություն
Wikimedia Foundation-ի իրավախորհրդատու Ջեյքոբ Ռոջերսը, մեկնաբանելով Bloomberg-ի բացահայտումը, կասկած է հայտնել, որ նման կրկնօրինակները կարող են երկարաժամկետ հաջողություն ունենալ առանց մեծաթիվ և ակտիվ խմբագիրների համայնքի։ «Մենք ընդհանրապես չենք տեսնում, որ նման կրկնօրինակներն ունենան երկարաժամկետ հաջողություն։ Նրանք կարող են որոշ ժամանակ վերարտադրել Վիքիպեդիայի բովանդակությունը, բայց չեն կարողանում այն պարբերաբար թարմացնել»,– ասել է նա։
Հայաստանի դեպքում ևս այս խնդիրը տեսանելի է։ Bloomberg-ի հայտնաբերած երեք կայքերը գոյություն ունեցան ընդամենը մի քանի ամիս, մինչև հոսթինգ մատակարարը դադարեցրեց դրանց սպասարկումը՝ առանց հրապարակային բացատրության։
Սակայն այս երեք կայքերի փակվելը դեռ չի նշանակում, որ փորձը ամբողջությամբ ձախողվել է։ Նույն ցանցի շրջանակում Bloomberg-ը հայտնաբերել էր նաև այլ կայքեր, որոնք հունիսի 9-ին չեն փակվել։ Բացի այդ, Գերմանիայի համար մշակվել էր նույն մոտեցման ավելի մեծածավալ տարբերակը։ Այս փաստերը ցույց են տալիս, որ Հայաստանի նախագիծը առանձին նախաձեռնություն չէր, այլ ավելի լայն ռազմավարության մի մաս, որի նպատակն էր ոչ միայն առանձին կեղծ տեղեկություններ տարածելը, այլև արհեստականորեն ստեղծված բովանդակության միջոցով ազդել տեղեկատվության որոնման և ներկայացման համակարգերի վրա։
Հետևաբար, այս պատմությունը կարևոր է ոչ միայն որպես երեք կայքերի կարճատև և տեխնիկապես ձախողված փորձ։ Ավելի կարևոր է այն մեթոդը, որը կարող է կրկին կիրառվել՝ ավելի քիչ ակնհայտ սխալներով և ավելի դժվար հայտնաբերվող հետքերով։ Մի կոնկրետ կայքի փակումը կարող է վերացնել տվյալ ենթակառուցվածքի մի մասը, բայց ինքնին չի վերացնում նման գործողությունների հիմքում ընկած մոտեցումը։
Հռիփսիմե Հովհաննիսյան
Տեսայութը պատրաստվել է Ապատեղեկատվության հոսքերի մոնիթորինգ նախագծի շրջանակներում

#CivilSocietyCooperation #ishrarmenia #ishrfactheck
Ծրագիրն իրականացվում է Գերմանիայի Դաշնային Հանրապետության Արտաքին գործերի նախարարության ֆինանսական աջակցությամբ